文档
Bot 灵魂与核心记忆
SOUL.md 与 MEMORY.md 如何进入每个 Session、字数上限,以及修改何时生效。
每个 PersonaBot 的 Memory 根目录里有两个特殊文件:SOUL.md 是它的灵魂(Soul),MEMORY.md 是它的核心记忆(Core Memory)。它们会在每个新 Session 开始时放进 system prompt,所以 Bot 一开口就知道自己是谁、记得哪些事,不用先翻文件。Memory 里的其他文件不会自动放进去,Bot 需要时再用工具读取。
为什么这样设计
没有常驻内容时,每个新 Session 的 Bot 都像刚醒来:不知道自己的 Memory 里有什么,只能先搜索、列目录、逐个打开文件,才能想起你们之前约定的事情。有了 MEMORY.md,Bot 在第一句话之前就能看到一份“我记得什么、放在哪里”的索引。
这两个文件在一个 Session 里是冻结的:Session 开始时读一次,之后哪怕文件在磁盘上被改了,这个 Session 看到的仍是开始时的版本。这样 system prompt 的前缀每一轮都完全相同,模型服务可以复用提示词缓存(prompt cache),长对话不会因为记忆变化而每轮重新计费、变慢。代价是改动要等到下一个 Session 或下一次压缩才生效,见下文。
两个文件分别代表什么
| 文件 | 名称 | 放什么 |
|---|---|---|
SOUL.md |
灵魂 | Bot 是谁:性格、说话方式、长期遵守的工作原则。创建 Bot 时填写的人格就写在这里。 |
MEMORY.md |
核心记忆 | Bot 一直带着的记忆:主要是一份索引,指向保存细节的 Memory 文件,再加上少数不能忘的关键事实。 |
两者的区别在于变化的速度。灵魂很少改,改了往往意味着 Bot 变成了“另一个人”;核心记忆会随着合作不断增长和整理。
老版本的 Bot 使用 PERSONA.md。升级后第一次启动时,它会被改名为 SOUL.md 并提交到 Memory 的 Git 历史,内容不变。
为什么没有 USER.md
有些 Agent 产品会再放一个 USER.md,专门记录“用户是谁”。DeepSeekBot 没有这样做:一个 PersonaBot 会在不同的 Channel、群聊和项目里和很多人合作,“用户”不止一个。关于某个人的记忆,和关于客户、项目的记忆一样,放在普通的 Memory 文件里(例如 people/小王.md),再从 MEMORY.md 里索引过去。这样记一个人和记一件事是同一套方法,人多了也不会挤爆 system prompt。
在哪里看到它们
打开 Bot 私聊 → Channel sidebar → 记忆文件。SOUL.md 和 MEMORY.md 固定排在最上面,带 常驻 标签,右侧是当前字数和上限:
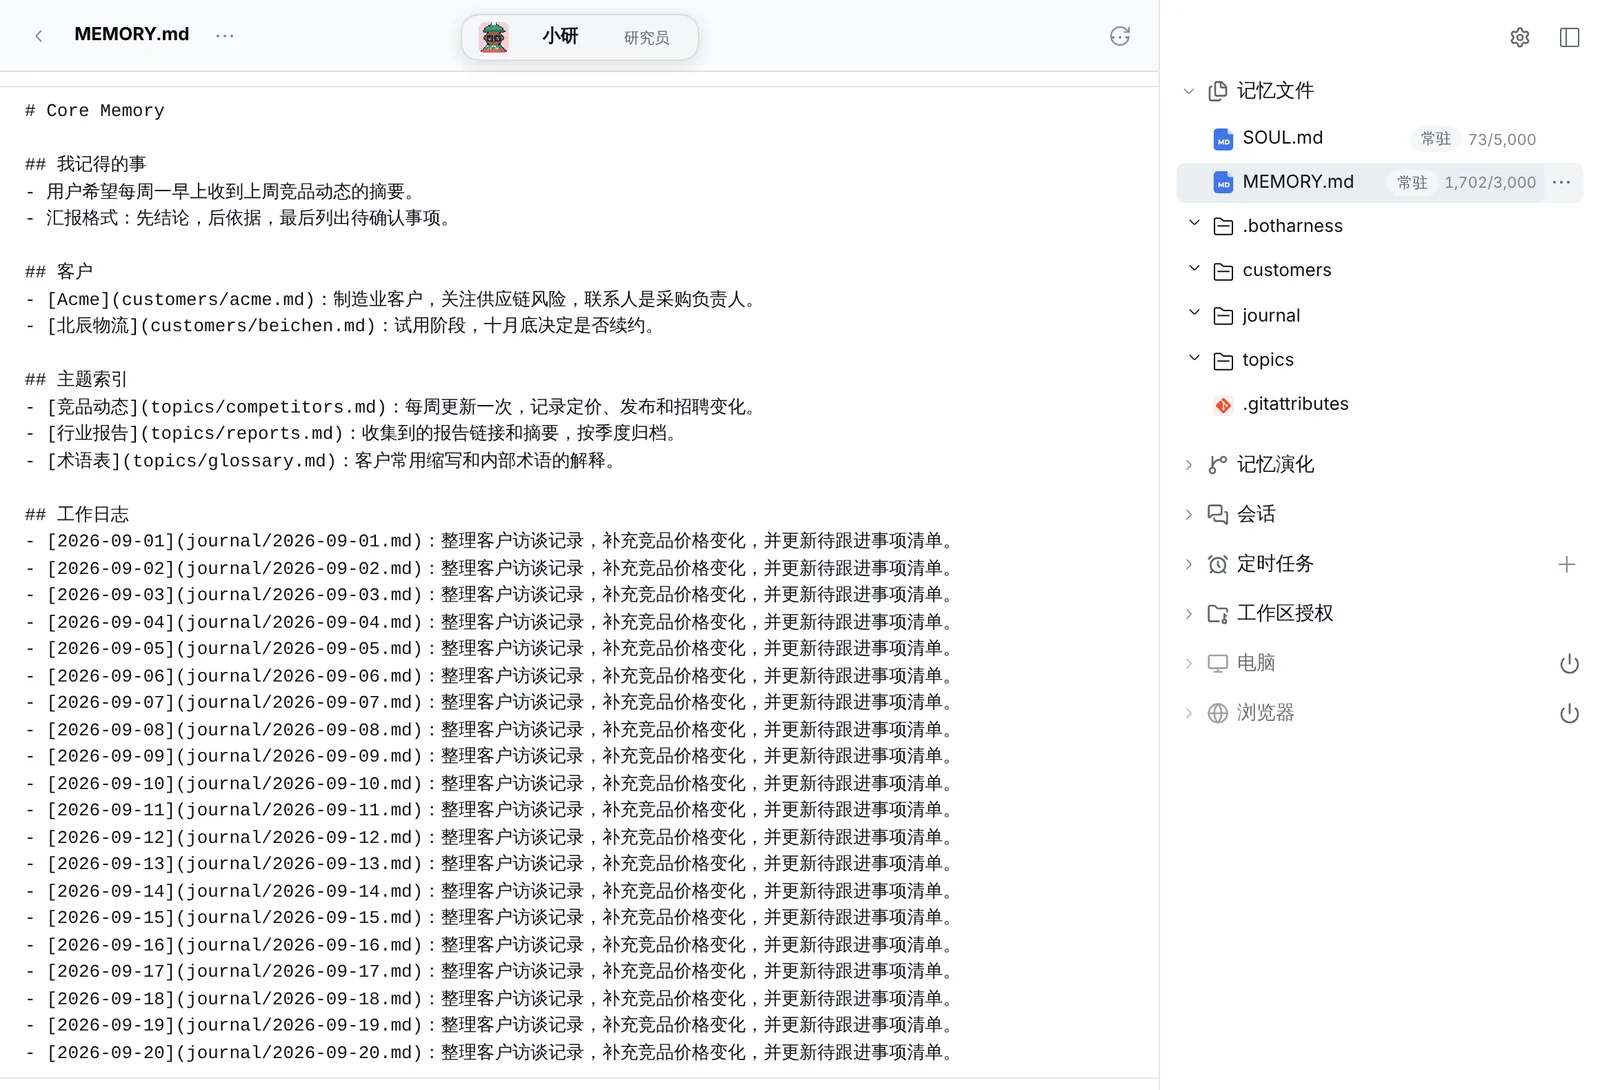
点击文件名可以查看全文。鼠标停在用量上会显示占上限的百分比。
字数上限
每个文件有各自的上限,单位是字符:一个汉字、一个英文字母、一个空格或标点都算一个字符。选字符而不是 token,是因为字符你自己就能数,而 token 数会因模型不同而变化。
| 文件 | 默认上限 | 大约相当于 |
|---|---|---|
SOUL.md |
5,000 | 5,000 个汉字,或约 830 个英文单词 |
MEMORY.md |
3,000 | 3,000 个汉字,或约 500 个英文单词 |
换算成 token 只能给个大概范围,具体取决于模型的分词器:
- 中文:每个汉字约 0.6 到 1 个 token。默认的两个文件写满,约 5,000 到 8,000 个 token。
- 英文:每 4 个字符约 1 个 token。默认的两个文件写满,约 2,000 个 token。
这部分内容每个 Session 都会带着。因为前缀不变、可以命中缓存,它通常不会让每一轮都按全价计费,但会占用上下文窗口。
修改上限
- 在 Bot 私聊顶部点击 Bot 名称,在弹出的资料卡里点击 查看详细。
- 找到 常驻记忆上限,分别填写 Soul 和 Core Memory 的字符数。可填 500 到 50,000 之间的整数,下方会显示大约相当于多少汉字或英文单词。
- 点击 保存上限。恢复默认 会改回 5,000 和 3,000。
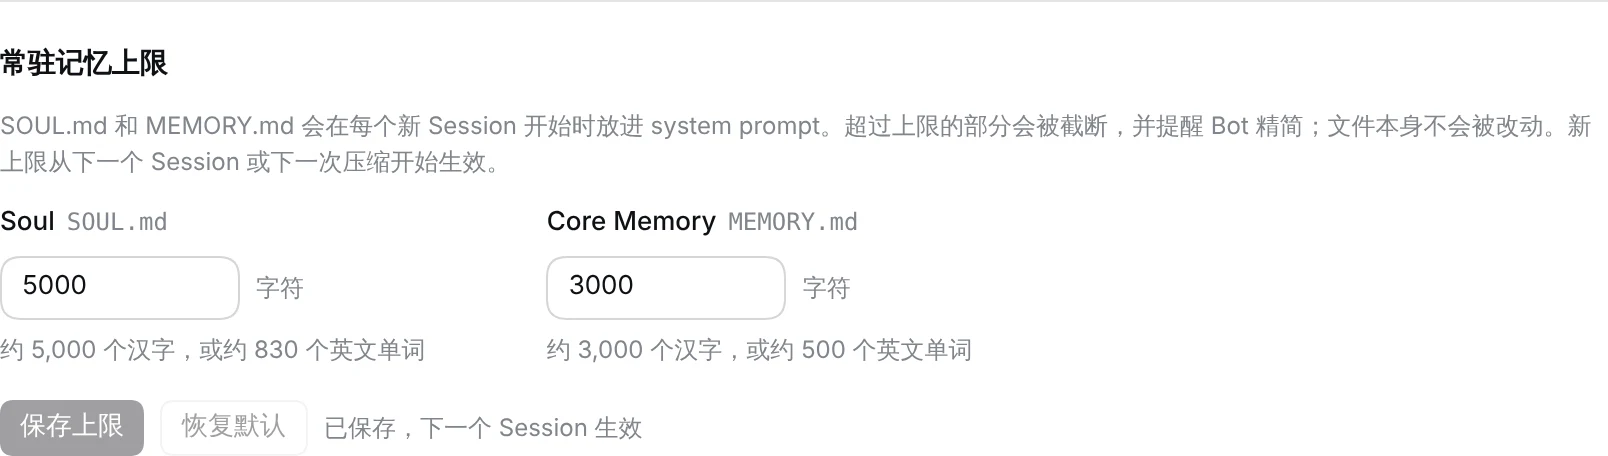
上限只属于这个 Bot,不影响其他 Bot。
超出上限时
文件不会被改动,也不会被删减。超出的部分只是不放进 system prompt:Bot 看到的是前面不超过上限的内容,后面跟着一行提示,告诉它这个文件超长了、需要精简,完整文件仍在磁盘上。记忆文件面板里,超限的用量会显示为红色:
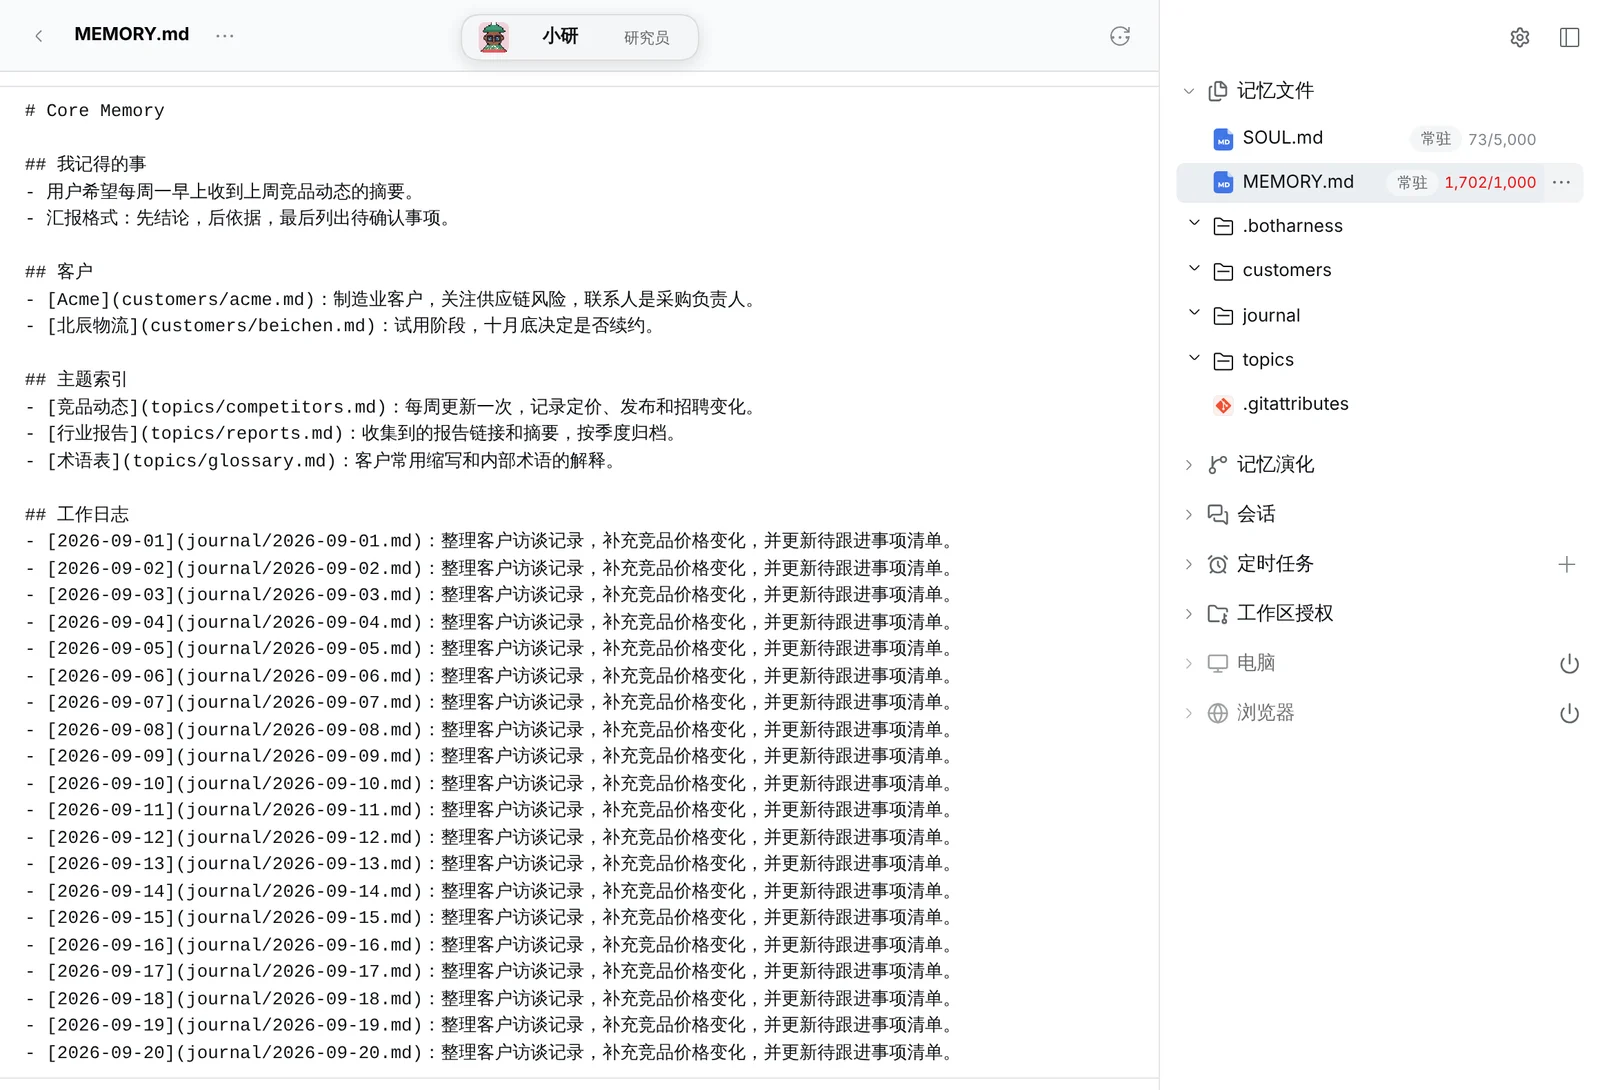
像上图这样每天都在增长的日志,应该放在单独的文件里。这时可以直接请 Bot 整理,例如:「你的 MEMORY.md 超过上限了,请把细节移到对应的主题文件,MEMORY.md 只保留索引和最关键的事实。」也可以调高上限。
修改什么时候生效
两个文件的内容和上限,都在以下任一时刻生效:
- Bot 的下一个 Session 开始时;
- 当前 Session 下一次压缩上下文(compaction)之后。
在那之前,正在进行的 Session 仍然使用开始时的版本。Bot 知道这一点:它在 Session 中途更新了 MEMORY.md,不会以为自己已经“记住”了新的版本,而是像对待其他 Memory 文件一样,需要时再去读。
这两个文件可以由 Bot 自己用记忆工具修改,也可以由你在 Host 上用编辑器修改(文件位置见在 Host 上打开文件)。每次修改都会进入 Memory 的 Git 历史,可以在记忆演化里查看和找回。
和 Bot 一起塑造 MEMORY.md
新建的 Bot 会得到一份很短的 MEMORY.md,只说明这个文件的用途,没有固定格式。怎么组织它,由你和 Bot 在合作中慢慢约定。这里没有标准答案,但有几条原理值得记住:
- 它是索引,不是仓库。 详细内容放在主题文件里,
MEMORY.md用一两行写清“什么事在哪个文件”。这样上限不容易用完,Bot 也知道去哪里找。 - 只放每次都该想起的事。 判断标准是:如果这件事 Bot 在新 Session 里不知道,会不会犯错或让你重复交代?会,就值得放进来;不会,放在主题文件里就够了。
- 定期整理。 记忆会自然增长,过时的条目、已经完成的项目,可以请 Bot 移到归档文件或删掉。
一个好的开始方式,是直接和 Bot 聊这件事:
看看你现在的 Memory 里都有什么,然后整理一下 MEMORY.md:让下次新对话一开始,你就知道自己记得哪些事、细节放在哪个文件。先把你打算怎么组织告诉我,我们商量好再改。
之后在合作中遇到“它怎么又忘了”的时候,就是调整 MEMORY.md 的好时机。